
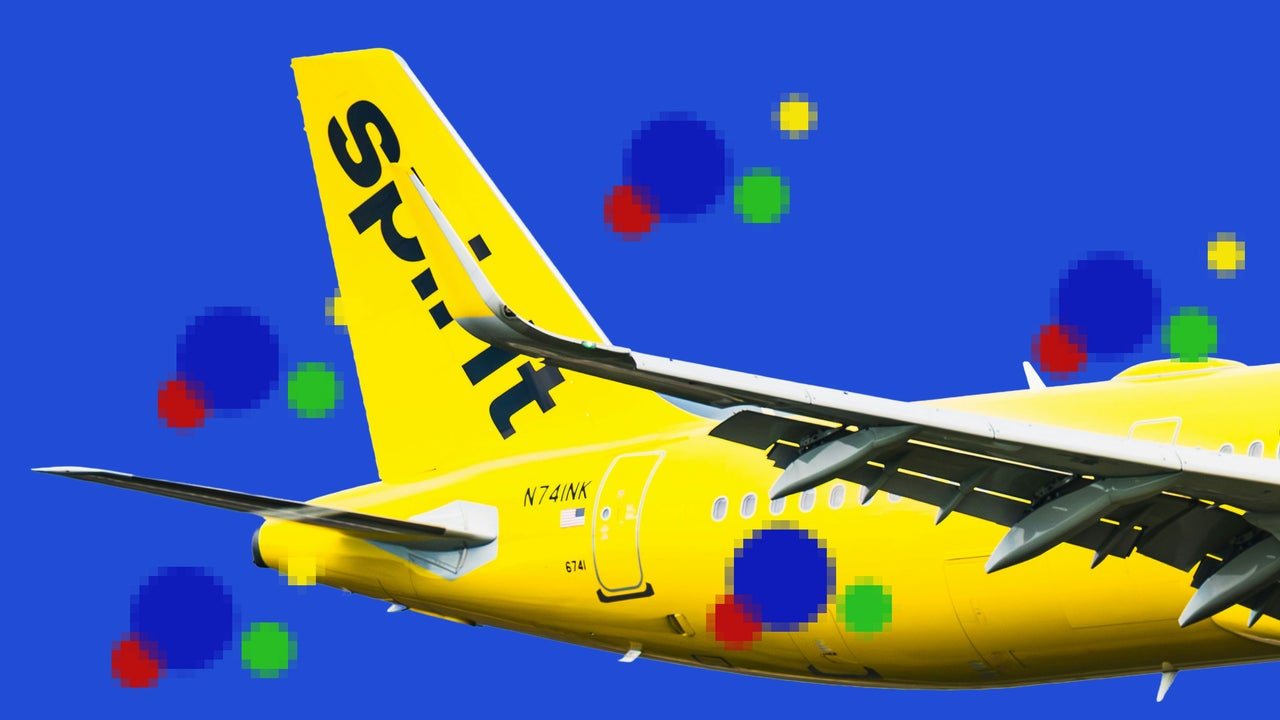
Google став переможцем аукціону на купівлю бізнес-архіву авіакомпанії Spirit Airlines, яка проходить процедуру банкрутства. Сума пропозиції — $10 млн. Архів містить близько 100 млн робочих листів співробітників, 500 млн повідомлень у Microsoft Teams, 30 млн рядків вихідного коду, а також дані про ціноутворення, польотні операції та графіки екіпажів. Google планує використати ці дані для тренування своїх ШІ-моделей.
Ця угода — не поодинокий випадок, а сигнал нового етапу в гонці ШІ. Ранні чат-боти навчалися переважно на загальнодоступній інформації з інтернету. Тепер, коли компанії розробляють агентів, здатних виконувати складні бізнес-завдання, попит зміщується в бік реальних даних про те, як працюють організації. Архів Spirit може навчити моделі не стільки авіаційній галузі, скільки тому, як співробітники спілкуються, співпрацюють і вирішують проблеми. Агент міг би переймати кроки, які працівники робили для розв'язання конкретної задачі, і застосовувати схожий підхід до зовсім інших ситуацій.
За словами адвоката з питань приватності даних Алекс Кімати з Holland & Hart, такі угоди стануть дедалі частішими, адже компанії усвідомлюють цінність своїх датасетів. Для Google $10 млн — відносно невелика сума, особливо якщо купівля цілого архіву виявляється дешевшою за ліцензування порівнянної інформації. Доля даних Spirit зараз вирішується у федеральному суді з питань банкрутства Південного округу Нью-Йорка. Google переміг на аукціоні, а компанія з підбору персоналу Mercor стала запасним покупцем із пропозицією $7,5 млн. Пізніше інша компанія, Micro1, подала заявку на $12,5 млн, намагаючись перехопити угоду до остаточного рішення суду, призначеного на 6 листопада.
Угода викликає серйозні питання щодо приватності. Ширші масиви даних Spirit включають мільйони імен авіапасажирів і номери кредитних карток, а також інформацію про тисячі співробітників. Google запевняє, що персональні дані будуть виключені з продажу, обіцяє видалити певні категорії чутливої інформації та найняти третю сторону для анонімізації архіву. Однак профспілка бортпровідників заперечує, стверджуючи, що навіть після видалення ідентифікаторів людей можна буде повторно ідентифікувати. Адвокат з приватності Метью Коул із Saul Ewing погоджується: навіть коли імена та інші ідентифікатори видалені, дані з різних джерел, як-от програми лояльності авіакомпаній або покупки на борту, іноді можна поєднати, щоб відновити особу. «Люди, які мають мотивацію, знаходять способи відтворити ідентичність окремих осіб у різних наборах даних», — каже він.
Google стоїть перед складним балансом: дані мають бути достатньо анонімізованими, щоб відповідати вимогам приватності, але не настільки знеособленими, щоб втратити цінність для тренування ШІ. «Це справді важко — зробити це й дотриматися юридичного стандарту фактичної деідентифікації», — зазначає Кімата. Він вважає скептицизм профспілки виправданим, зважаючи на складність гарантування того, що людей неможливо буде ідентифікувати за залишковою інформацією.
Приватність — лише частина ширшої проблеми. ШІ-компанії відчувають дедалі більший голод за даними, і оскільки значна частина загальнодоступного вебу вже використана для тренування, вони звертаються до спеціалізованих джерел. В епоху ШІ-агентів найціннішим і найдефіцитнішим ресурсом стають дані про процеси: агенти можуть навчатися на інформації про те, як працівник чи людина крок за кроком виконує складне завдання і як використовує зв'язки з додатками та інструментами. Архів Spirit — один із прикладів того, як компанії можуть придбати таку інформацію в масштабі.
Подібні потреби змінюють і умови надання споживчих ШІ-сервісів. Anthropic, наприклад, перейшла до тренування на споживчих чатах за замовчуванням, якщо користувач не відмовиться. ШІ-компанії змагаються за те, щоб надати персонального агента кожному — згадати хоча б Meta Muse, OpenAI Dots і Anthropic Duet. У міру зростання корисності та довіри до таких агентів вони можуть ставати сховищами величезних обсягів персональних даних і, відповідно, дедалі більше думати за користувача. Звісно, потік бізнесових і персональних даних до кількох закритих, непрозорих фронтирних моделей зосереджує величезну владу в руках компаній, які ними володіють. І ризики, притаманні цьому, можуть виходити за межі приватності.
Для українських команд ця історія — практичний сигнал. По-перше, варто переглянути власні політики щодо даних: чи готові ви продавати або ліцензувати внутрішні архіви, і чи захищені вони від подібних сценаріїв у разі банкрутства чи зміни власника. По-друге, якщо компанія тренує власні моделі або агентів, варто звернути увагу на процесні дані — логи взаємодій, історії підтримки, записи в CRM — адже саме вони стають конкурентною перевагою. По-третє, анонімізація має бути справді надійною: юристи попереджають, що рекомбінація даних із різних джерел здатна відновити ідентичність. В умовах, коли ринок ліцензованих даних зростає, українським продуктовим і маркетинговим командам варто заздалегідь прописати, які дані можна використовувати для навчання ШІ, а які — ні.
3