
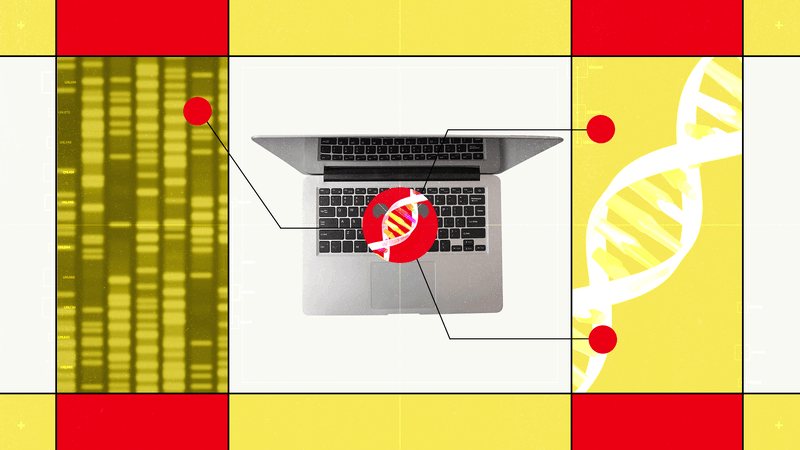
Hugging Face випустила Carbon-X — відкриту ШІ-модель, яка дозволяє дослідникам ставити запитання про ДНК звичайною мовою. Користувач вставляє генетичну послідовність, формулює запитання і отримує відповідь разом із поясненням. Це не чатбот загального призначення, а інструмент для біологічних досліджень, і саме тому реліз важливий для розуміння того, куди рухаються відкриті наукові моделі.
За карткою моделі, партнерами проєкту виступили Telethon Institute of Genetics and Medicine та Університет Неаполя Федеріко II. Модель поширюється як open-source, тобто команди можуть не лише користуватися нею через інтерфейс, а й розгортати у власній інфраструктурі, перевіряти поведінку на своїх даних і будувати похідні рішення. Для дослідницьких груп це принципово інший рівень контролю порівняно із закритими API.
Друга модель із пакета джерел описує Carbon-X як інструмент, що «розмовляє мовою ДНК» і допомагає зрозуміти, як зміни в послідовності впливають на активність генів та здоров'я. Це ключова деталь: йдеться не про загальні відповіді на кшталт «що таке ген», а про роботу з конкретними варіаціями послідовності та їхніми наслідками. Саме на стику генетики й машинного навчання сьогодні з'являються моделі, які можуть скоротити рутинну частину роботи біоінформатиків.
Для українського контексту тут є кілька практичних площин. По-перше, open-source-модель можна тестувати без бюджету на комерційну ліцензію — це актуально для університетських лабораторій і невеликих R&D-команд, які не мають доступу до дорогих закритих платформ. По-друге, підхід «послідовність плюс запитання звичайною мовою» варто розглядати як шаблон для інших вузьких доменів: так само можна будувати інтерфейси до власних даних у фінтеху, агротеху чи медичних реєстрах, де важливо не просто отримати відповідь, а й побачити пояснення.
Водночас не варто переоцінювати реліз. Carbon-X — це дослідницький інструмент, а не медичний продукт, і жодних заяв про клінічне застосування в матеріалах немає. Для команд, які працюють із чутливими генетичними даними, критичними залишаються питання локального розгортання, відтворюваності результатів і того, на яких даних модель тренували. Відкритість коду тут допомагає саме тому, що дозволяє перевіряти, а не вірити на слово.
Що з цього взяти в роботу: якщо у вас є складна предметна область із великою кількістю структурованих даних, подивіться на Carbon-X як на приклад продуктового дизайну — один вхідний артефакт, одне запитання, одна пояснювана відповідь. Це значно ближче до реальних робочих процесів, ніж універсальний чат із порожнім полем введення.
3